記事には手を入れているのに、構造化データだけ後回しになっている。そんな状態なら、全部のschemaを一気に覚えるより、まずはArticleとFAQPageの2つに絞った方が早いです。迷いやすいのは種類の多さではなく、どのページに何を入れるかの判断です。そこが決まれば、実装作業は想像より単純になります。
まず結論:構造化データはArticleから入れ、FAQPageは本文に実在するQ&Aだけ追加する
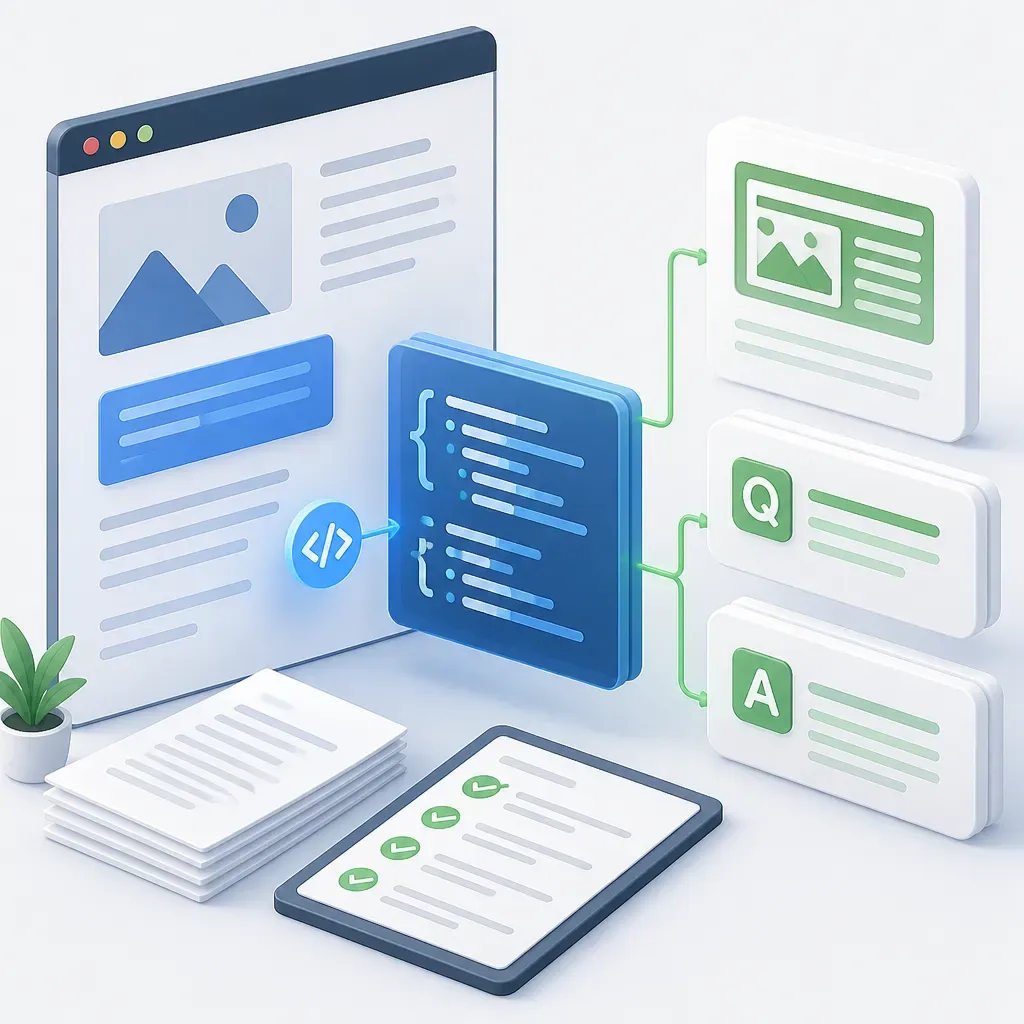
最初の優先順位は明確です。構造化データをこれから整えるなら、全記事の土台になるArticleを先に入れ、FAQPageは必要なページだけに追加します。
理由は2つあります。1つ目は、Articleが記事ページの基本情報を検索エンジンに渡しやすいことです。タイトル、公開日、更新日、著者、画像、発行者が揃うだけでも、ページの意味がぶれにくくなります。2つ目は、FAQPageは対象条件を外すと逆に整合性を崩しやすいことです。本文にない質問を足したり、見出しだけQ&A風にして機械的にマークアップしたりすると、実装したのに評価に結びつかない状態になりやすいです。
FAQPageは万能ではありません。Google検索ではFAQの表示面が一般サイトで限定されていると整理されており、仕様の理解にはFAQ構造化データの適用ルールを整理した解説が参考になります。そのうえで、本文に実在する質問と回答を明示できるページなら、検索エンジンやAIに情報の区切りを伝える用途は残ります。
構造化データを入れる前に決めることは3つだけ
実装前に決める項目は多くありません。どのページに入れるか、どの書式で出すか、誰が更新責任を持つか。この3点だけ先に決めれば、途中で止まりにくくなります。
Articleを入れるページ:ブログ記事・お知らせ・コラム
Articleを入れる対象は、本文が主役のページです。ブログ記事、事例記事、お知らせ、コラムが中心になります。逆に、カテゴリ一覧、タグ一覧、検索結果ページのような一覧ページは、同じ扱いにしない方が安全です。
固定ページでも、長い解説コンテンツなら候補になります。ただし、会社概要や問い合わせのように記事本文ではなく組織情報の提示が主目的なら、別の型を優先した方が自然です。Articleは「読むページ」に使う、と覚えると判断しやすくなります。
FAQPageを入れるページ:本文内に質問と回答が掲載されている記事だけ
FAQPageを入れてよいのは、ページ本文の中に質問と回答がそのまま存在している場合だけです。よくある失敗は、別ページのFAQを流用することと、問い合わせで聞かれそうな内容を本文に載せないままJSON-LDだけ追加することです。
質問文と回答文は、読者がページ上で目視できる状態に揃えてください。生成AIに拾われることを期待してFAQだけ裏で増やすやり方は、情報設計としても不自然です。FAQの中身そのものの作り方は、FAQPage構造化データを入れてもAI検索に拾われない理由と直し方で詰まりやすい箇所が整理されています。
実装方式はJSON-LDを選べば最短
最短で進めるなら、構造化データの書式はJSON-LDで統一します。HTML本文の各要素に属性を埋め込むMicrodataより、コードの管理場所を分けやすいからです。修正時も差分を追いやすく、非エンジニアが確認しやすい利点があります。
構造化データの基本的な考え方や、JSON-LDが扱いやすい理由は構造化データの設定手順を解説した記事でも整理されています。初心者ほど、まず1つの書式に寄せた方が運用が乱れません。
あなたのサイトは、検索とAIにどう見えているか——3分で無料診断
サイトURLを入れるだけで、メディア健康度と「どの記事から手を入れるべきか」の優先リスト(実記事名つき)をAIが無料でレポートします。登録不要・約3分。
最短で実装する手順1:Articleの構造化データを入れる
最初に入れるべき構造化データはArticleです。ここで大事なのは、項目を増やすことではなく、本文と一致する基本情報を欠けなく出すことです。
コピペで使えるArticleのJSON-LD例
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "記事タイトル",
  "image": ["https://example.com/article-image.jpg"],
  "datePublished": "2026-10-04",
  "dateModified": "2026-10-04",
  "author": {
    "@type": "Person",
    "name": "著者名"
  },
  "publisher": {
    "@type": "Organization",
    "name": "サイト名または運営組織名",
    "logo": {
      "@type": "ImageObject",
      "url": "https://example.com/logo.png"
    }
  },
  "mainEntityOfPage": {
    "@type": "WebPage",
    "@id": "https://example.com/article-url/"
  }
}
</script>
この形なら、最低限の意味を渡せます。見栄えのために項目を増やすより、URL、日付、著者名、画像URLの一致を先に確認してください。
Articleで最低限そろえたい項目と、空欄にしない項目
空欄にしたくないのはheadline、datePublished、dateModified、author、mainEntityOfPageです。ここが抜けると、記事としての識別が弱くなります。imageとpublisherも、実務ではほぼ必須と考えた方が管理しやすいです。
dateModifiedは更新していないのに機械的に毎回変えない方が無難です。本文更新日と構造化データの日付がずれると、ページ上の事実と食い違います。authorは「編集部」のような包括名でも構いませんが、サイト内の表記と揃えてください。本文が個人名表記なのにJSON-LDだけ別名義、というズレは残さない方がきれいです。
HTMLサイトとWordPressで、Articleの構造化データをどこに貼るか
貼る場所は、head内がもっとも管理しやすいです。body内でも読まれることはありますが、運用ルールとしてはheadに寄せた方が迷いません。
静的HTMLなら、各記事ページのheadにscriptタグを直接入れます。WordPressなら、テーマが既にArticleを出力していないか先に確認してください。SEO系プラグインやテーマ機能と二重出力になると、同じページに複数のArticleが並ぶことがあります。まずはソースを表示し、application/ld+jsonを検索するだけでも確認できます。
最短で実装する手順2:FAQPageの構造化データを追加する
FAQPageは、Articleの次です。記事ページの本文にQ&Aブロックがあり、質問と回答が1対1で対応しているなら追加できます。
コピペで使えるFAQPageのJSON-LD例
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "FAQPage",
  "mainEntity": [
    {
      "@type": "Question",
      "name": "構造化データはどのページから入れるべきですか?",
      "acceptedAnswer": {
        "@type": "Answer",
        "text": "記事本文が主役のページからArticleを入れ、FAQが本文内にある記事だけFAQPageを追加します。"
      }
    },
    {
      "@type": "Question",
      "name": "FAQPageは本文にない質問も入れてよいですか?",
      "acceptedAnswer": {
        "@type": "Answer",
        "text": "入れない方が安全です。ページ上で読者が確認できる質問と回答だけをそのまま構造化します。"
      }
    }
  ]
}
</script>
本文側のQ&Aと、JSON-LD側の文言は揃えてください。語尾まで一字一句同じである必要はありませんが、意味が変わる編集は避けた方が無難です。
FAQPageで失敗しやすい3つの条件
失敗しやすいのは3つです。本文にない質問を入れる、1問1答の対応が崩れている、回答が短すぎて意味が閉じていない。この3つは修正対象として優先してください。
たとえば回答が「はい、可能です。」だけだと、単独で読んだときに何が可能なのか分かりません。構造化データは文脈を失って参照される可能性があります。回答だけ抜き出されても意味が通る長さにしておく方が、AI検索でも通常検索でも扱いやすくなります。
ArticleとFAQPageの構造化データを同じページで併用してよいケース
併用して問題ないのは、記事本文が主で、その中にFAQセクションが実在するケースです。解説記事の末尾に「よくある質問」を置く形が典型です。
一方で、ページ全体がFAQ一覧で、記事というより質問集そのものなら、Articleを無理に重ねなくても成立する場合があります。どちらを主役にするかは、ページの読み方で決めてください。記事を読ませるページならArticle中心、質問集ならFAQ中心です。
公開前にやること:構造化データのエラーを最短で確認する手順
実装後に必ずやるべきなのは、見た目の確認ではなく、機械がどう読んだかの確認です。コードを貼っただけでは終わりません。
リッチリザルトテストで見る場所と、よくある警告の読み方
最初に見るのは、エラーがあるかどうかです。エラーは公開前に直し、警告は項目の意味を読んで優先度を判断します。警告だから常に放置してよいわけではありません。画像や著者情報の欠落のように、ページ理解に関わるものなら埋める価値があります。
確認時はURL入力だけで済ませず、レンダリング結果の検出型も見てください。想定したArticleやFAQPageが出てこないなら、そもそも出力場所や記述形式に問題がある可能性があります。
Search Consoleで確認したい項目
公開後は、URL検査でインデックス登録状況を見ます。クロール未達や重複判定があると、構造化データ以前の問題で止まります。拡張レポートは対象タイプによって表示されないこともあるため、出ないだけで失敗と決めつけない方が安全です。
インデックス自体に不安があるなら、GSCでインデックス未登録が増えたときの原因を切り分ける実務手順の流れで先に土台を確認した方が早く進みます。
ページ本文と構造化データが一致しているかを最後に見直す
最後は人の目で照合します。タイトル、公開日、更新日、著者名、アイキャッチ画像、FAQの質問文と回答文。この6点がページ本文とJSON-LDで揃っていれば、大きなズレは減らせます。
更新運用に入ると、本文だけ直して構造化データを放置しやすくなります。公開前より、更新時の方が不一致は増えます。更新フローにチェック項目として組み込む方が現実的です。
FAQPageは今も入れるべきか?構造化データをAI検索とSEOの両方で考える
結論として、本文に実在するQ&Aがあるなら今も入れる価値があります。ただし、狙いはFAQリッチリザルトだけに置かない方がよいです。
FAQPageの表示面は限定的でも、ページ理解を助ける価値は残る
FAQPageは、検索結果で目立つためだけの記述ではありません。質問と回答の対応関係を明示できるので、ページ内の情報整理として意味があります。Google検索での表示条件が限られていても、実装価値がゼロになるわけではありません。
特に、サービス説明ページや長文記事の末尾で疑問を整理する使い方は、読者にも機械にも分かりやすい形です。構造化データは順位を直接押し上げる魔法ではありませんが、内容理解の補助線にはなります。
生成AIに引用されやすくするなら、構造化データだけでなく本文の要約ブロックも整える
AI検索を意識するなら、構造化データだけでは足りません。本文冒頭や各見出し直下に、要点を短く切り出したブロックを置いた方が、引用単位として扱われやすくなります。質問に対して結論を先に書く構成も効きます。
差が出やすいのは、コードの有無より本文の切り出しやすさです。引用される記事とされにくい記事の違いは、AI検索で引用された記事の共通点を実測比較した内容を見ると、構造と本文設計を分けて考えない方がよい理由がつかめます。
初心者が迷わない公開前チェックリスト
公開前の確認は、次の順番にすると詰まりません。
- 記事ページにはArticleを入れたか
- FAQPageは本文に実在するQ&Aだけを対象にしたか
- 書式はJSON-LDで統一したか
- title、日付、著者、画像URLが本文と一致しているか
- WordPressやプラグインとの二重出力がないか
- リッチリザルトテストでエラーが出ていないか
- 公開後にURL検査でクロールと登録状況を確認したか
迷ったときは、項目を増やすより不一致を減らす判断が先です。構造化データは、種類の多さで差がつく施策ではありません。記事本文、運営情報、FAQの整合性まで含めて見直したい場合は、当サイトの無料メディア診断で確認ポイントを整理できます。
あなたのサイトは、検索とAIにどう見えているか——3分で無料診断
サイトURLを入れるだけで、メディア健康度と「どの記事から手を入れるべきか」の優先リスト(実記事名つき)をAIが無料でレポートします。登録不要・約3分。